PDF翻译在医疗合规中的生死局:格式保留与术语精准如何兼得
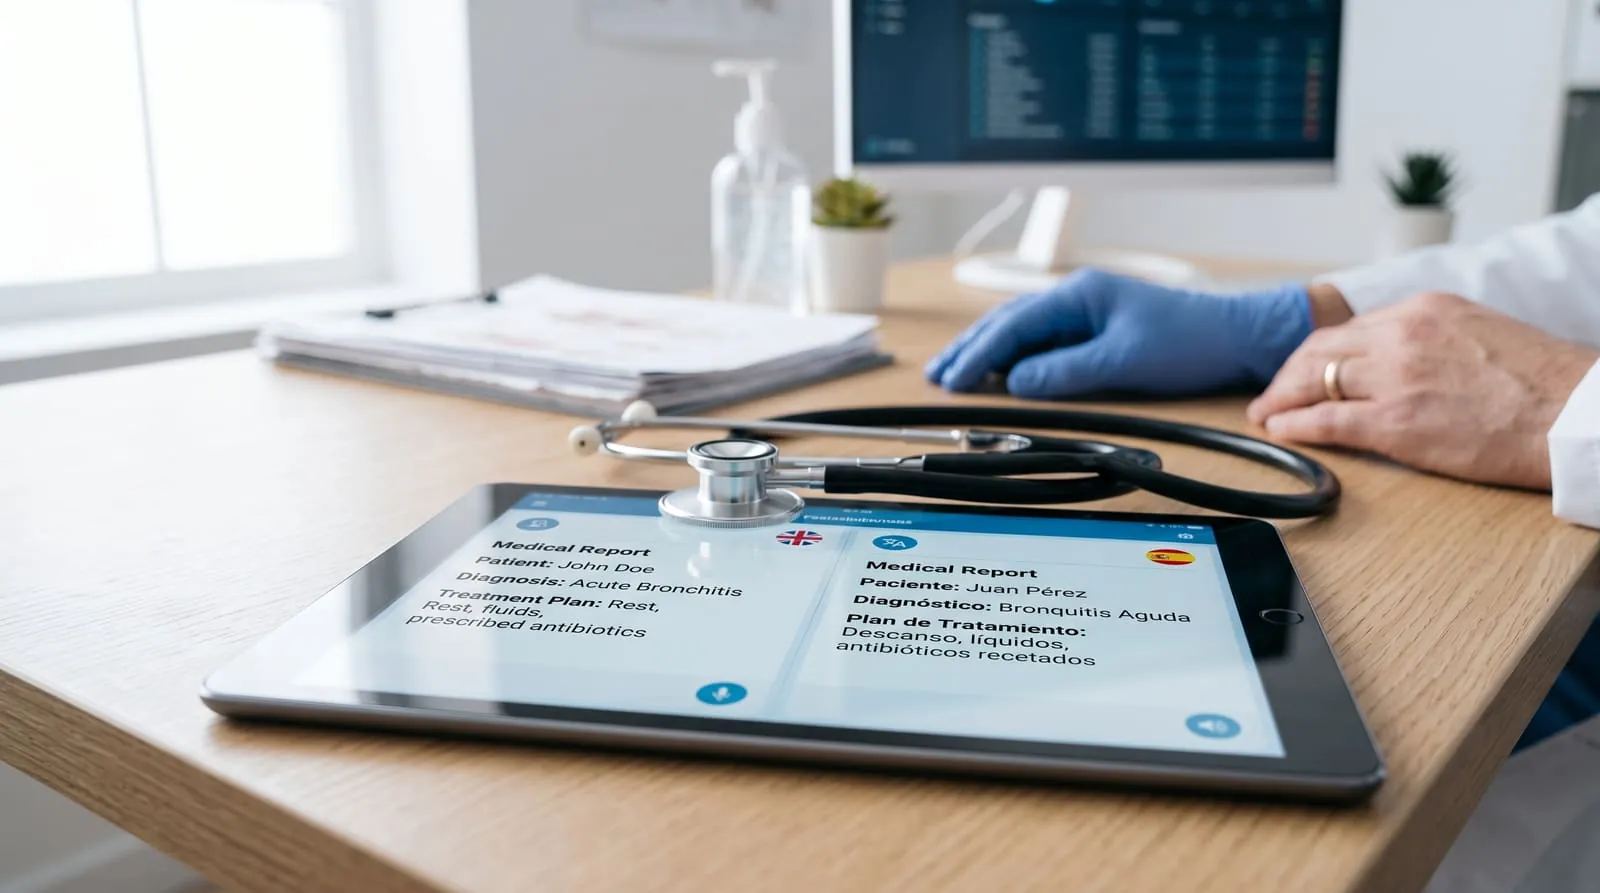
医疗PDF文档翻译绝非文字转换。本文从ISO 17100流程切入,拆解PDF排版翻译在eCTD提交、IFU本地化中的格式保留陷阱,提供可落地的工程检查清单与术语库管理策略。
医疗PDF翻译:一个标点错位就可能让申报退回
去年一家器械厂商的EU MDR技术文档在公告机构审核时被卡住。原因不是临床数据,而是一份PDF格式的IFU(使用说明书)中,德语版表格的计量单位列整体错位了一行。审核员直接标注"不可接受"。
这不是孤例。医疗行业的PDF文件翻译,从来不是把英文替换成中文那么简单。它是一场格式保真、术语一致、法规符合性的三重博弈。
为什么PDF是翻译工程里最难啃的骨头
PDF的设计初衷是"所见即所得"的打印格式,而非结构化数据容器。这就意味着,当你把一份PDF文档翻译成另一种语言时,文本流、表格、页眉页脚、脚注、图注之间的逻辑关系,全靠翻译工程师手动重建。
医疗文档尤其棘手:
- eCTD提交文件:FDA和EMA要求严格的PDF版本(PDF/A)、书签层级、超链接有效性。翻译后任何元数据丢失都可能导致技术性拒收。
- IFU(使用说明书):EU MDR 2017/745附录I第23章明确要求语言可接受性,且符号、警示语必须与源文件位置严格对应。
- 临床研究报告(CSR):表格跨页断行、统计符号(如±、≤、α)的字体嵌入问题,翻译后极易出现乱码。
我们处理过一份带嵌套表格的器械临床评价报告,源文件用了三种字体嵌入,其中一种不支持中文。直接替换文本会导致所有希腊字母变成方框。解决方案是重构字体子集,再逐段回填。
保留格式翻译的工程化路径
单纯用OCR或转换工具处理PDF,在医疗场景下是自杀式操作。我们的标准流程分四步:
第一步:PDF解剖与结构映射
先用工具(如Adobe Acrobat Pro的"辅助工具"或pdfplumber)提取文本层、图像层、矢量图形层。标记出所有需要翻译的文本块,同时记录每个块的坐标、字体、字号、对齐方式。这一步的输出是一份结构映射表,而非直接翻译。
第二步:术语库与翻译记忆库锁定
医疗PDF文档翻译的术语一致性直接关联法规符合性。比如"adverse event"在CIOMS报告里必须统一译为"不良事件",不能与"副作用"混用。我们会在项目启动前,从客户的历史eCTD文件、MedDRA术语集、公司术语表中抽取高频词,建立项目专属术语库。
一个反直觉的经验:术语库不是越大越好。超过5000条的术语库如果不做场景分层,译员反而容易误用。我们通常按"法规术语""临床术语""器械术语"三层管理。
第三步:排版重建与回填
这是PDF排版翻译的核心环节。我们使用CAT工具(如Trados或memoQ)的PDF对齐功能,将源文本与译文段落一一对应,再导出为保留原始布局的格式(如DOCX或IDML),由排版工程师手动调整表格列宽、行距、断字规则。中文译文通常比英文短20%-30%,需要重新平衡版面,避免出现大片空白。
第四步:格式验证与合规检查
交付前必须跑一遍检查清单:
| 检查项 | 标准 | 工具示例 |
|---|---|---|
| PDF/A合规性 | ISO 19005-1 | veraPDF |
| 书签与超链接 | 与源文件一致 | Acrobat Pro |
| 字体嵌入 | 所有字体子集完整 | Preflight |
| 表格跨页断行 | 无内容割裂 | 人工复核 |
| 术语一致性 | 术语库匹配率≥98% | QA Distiller |
医疗PDF翻译的常见翻车点
翻车点一:页眉页脚的"隐形"文本。很多PDF的页眉包含文档编号和版本号,翻译时容易被忽略。但公告机构审核时,版本号错位是致命伤。
翻车点二:图注与图内文字的分离。影像学报告里的标注文字如果嵌在图像里,需要图像本地化团队介入,而不是简单翻译文本层。
翻车点三:符号与单位。医疗文档中的"μg""℃""±"等符号,翻译后字体回退可能导致显示异常。必须逐字符验证Unicode映射。
如何选择靠谱的PDF翻译服务商
别只看报价单。问三个问题:
- 你们有没有医疗垂直的术语库和译员资质?(ISO 17100要求译员具备领域能力)
- PDF排版翻译后,你们用什么工具做格式验证?
- 能否提供eCTD格式的PDF/A输出?
如果对方含糊其辞,换一家。
医疗PDF文档翻译的容错率极低。一份IFU的排版错误可能延误产品上市数月,一份CSR的格式问题可能触发监管问询。把PDF翻译当成工程问题而非语言问题来对待,才是正解。
需要针对你的医疗PDF文档做一次格式与术语的可行性评估?我们的技术团队可以提供样本测试,不收费。
分享这篇文章